可观测性
AI 服务可观测性
AI 服务可观测性是一项实验性功能。其 API 和行为可能在未来版本中发生变化。
AI 服务可观测性机制允许用户跟踪 AiService 调用期间发生的情况。单次调用可能涉及多次 LLM 调用,其中任何一次都可能成功或失败。AI 服务可观测性使用户能够跟踪完整的调用序列及其结果。
AI 服务可观测性能力仅在使用 AI 服务 时可用。它们是更高层级的构造,无法应用于 ChatModel 或 StreamingChatModel。
该实现最初在 Quarkus LangChain4j 扩展 中实现,并被回移植到此处。
事件类型
每种事件类型都有唯一标识符,可用于跨多次调用关联事件。
每种事件类型都包含封装在
InvocationContext
中的信息。
当前可用的事件类型如下:
| 事件名称 | 描述 |
|---|---|
AiServiceStartedEvent | 在 LLM 调用开始时触发。 |
AiServiceRequestIssuedEvent | 在向 LLM 发送请求之前触发。包含正在发出的请求的详细信息。需要注意的是,当存在工具或护栏时,在单次 AiService 调用期间此事件可能被触发多次。 包含系统消息和用户消息等信息。 |
AiServiceResponseReceivedEvent | 在收到 LLM 响应时触发。包含 LLM 响应以及对应的请求。需要注意的是,当存在工具或护栏时,在单次 AiService 调用期间此事件可能被触发多次。 包含系统消息和用户消息等信息。 并非每次调用都会收到此事件。如果调用失败,将改为收到 AiServiceErrorEvent。 |
AiServiceErrorEvent | 在与 LLM 的调用失败时触发。失败原因可能是网络故障、AiService 不可用、输入/输出护栏阻止请求,或其他许多原因。 包含有关所发生故障的信息。 |
AiServiceCompletedEvent | 在 LLM 调用成功完成时触发。 并非每次调用都会收到此事件。如果调用失败,将改为收到 AiServiceErrorEvent。包含有关调用结果的信息。 |
ToolExecutedEvent | 在工具调用完成时触发。需要注意的是,在单次 LLM 调用中此事件可能被触发多次。 包含有关工具请求和结果的信息。 |
InputGuardrailExecutedEvent | 在 输入护栏 验证执行时触发。每个护栏调用都会触发其中一个事件。 包含有关单个输入护栏的输入、其输出(即成功还是失败)以及执行时长的信息。 |
OutputGuardrailExecutedEvent | 在 输出护栏 验证执行时触发。每个护栏调用都会触发其中一个事件。 包含有关单个输出护栏的输入、其输出(即成功?失败?重试?重新提示?)以及执行时长的信息。 |
监听事件
每种事件类型都有自己的监听器,可以实现它来接收该事件。你可以挑选并选择要监听的事件。
要监听事件,请创建自己的类并实现你想监听的监听器接口。可用的监听器接口如下:
定义监听器后,在创建 AI 服务 时注册它们。AiServices 类 上有多种 registerListener 方法变体。
例如,你可以按如下方式创建并注册一个用于 AiServiceCompletedEvent 的监听器:
import java.time.Instant;
import java.util.List;
import java.util.Optional;
import java.util.UUID;

import dev.langchain4j.observability.api.AiServiceListenerRegistrar;
import dev.langchain4j.observability.api.event.AiServiceCompletedEvent;
import dev.langchain4j.observability.api.listener.AiServiceCompletedListener;
import dev.langchain4j.invocation.InvocationContext;

public class MyAiServiceCompletedListener implements AiServiceCompletedListener {
    @Override
    public void onEvent(AiServiceCompletedEvent event) {
        InvocationContext invocationContext = event.invocationContext();
        Optional<Object> result = event.result();

        // The invocationId will be the same for all events related to the same LLM invocation
        UUID invocationId = invocationContext.invocationId();
        String aiServiceInterfaceName = invocationContext.interfaceName();
        String aiServiceMethodName = invocationContext.methodName();
        List<Object> aiServiceMethodArgs = invocationContext.methodArguments();
        Object chatMemoryId = invocationContext.chatMemoryId();
        Instant eventTimestamp = invocationContext.timestamp();

        // Do something with the data
    }
}

// When creating your AI Service
MyAiServiceCompletedListener myListener = new MyAiServiceCompletedListener();

var myService = AiServices.builder(MyAiService.class)
        .chatModel(chatModel)  // Could also be .streamingChatModel(...)
        .registerListener(myListener)
        .build();
创建自定义事件和监听器
AI 服务可观测性能力设计为可扩展。如果你想创建自己的事件,可以通过实现 AiServiceEvent 接口来定义自己的事件。
然后,通过实现 AiServiceListener 接口来创建自己的事件监听器。
拥有事件和监听器后,你需要通过获取/管理 AiServiceListenerRegistrar 实例并调用 fireEvent(event) 方法来触发事件。
事件开始被触发后,你可以像对待内置事件一样创建并注册监听器。
扩展点
你还可以实现 AiServiceListenerRegistrarFactory,并通过 Java 服务提供者接口(Java SPI) 注册它,从而创建自己的自定义 AiServiceListenerRegistrar。
如果你想管理注册/注销监听器的方式,和/或想控制如何触发事件,这会很有用。
Chat 模型可观测性
ChatModel 和 StreamingChatModel 的某些实现
(见「Observability」列)允许配置 ChatModelListener(s) 以监听如下事件:
- 对 LLM 的请求
- 来自 LLM 的响应
- 错误
这些事件包含各种属性,如 OpenTelemetry Generative AI Semantic Conventions 中所述,例如:
- 请求:
- Messages
- Model
- Temperature
- Top P
- Max Tokens
- Tools
- Response Format
- 等等
- 响应:
- Assistant Message
- ID
- Model
- Token Usage
- Finish Reason
- 等等
以下是使用 ChatModelListener 的示例:
ChatModelListener listener = new ChatModelListener() {

    @Override
    public void onRequest(ChatModelRequestContext requestContext) {
        ChatRequest chatRequest = requestContext.chatRequest();

        List<ChatMessage> messages = chatRequest.messages();
        System.out.println(messages);

        ChatRequestParameters parameters = chatRequest.parameters();
        System.out.println(parameters.modelName());
        System.out.println(parameters.temperature());
        System.out.println(parameters.topP());
        System.out.println(parameters.topK());
        System.out.println(parameters.frequencyPenalty());
        System.out.println(parameters.presencePenalty());
        System.out.println(parameters.maxOutputTokens());
        System.out.println(parameters.stopSequences());
        System.out.println(parameters.toolSpecifications());
        System.out.println(parameters.toolChoice());
        System.out.println(parameters.responseFormat());

        if (parameters instanceof OpenAiChatRequestParameters openAiParameters) {
            System.out.println(openAiParameters.maxCompletionTokens());
            System.out.println(openAiParameters.logitBias());
            System.out.println(openAiParameters.parallelToolCalls());
            System.out.println(openAiParameters.seed());
            System.out.println(openAiParameters.user());
            System.out.println(openAiParameters.store());
            System.out.println(openAiParameters.metadata());
            System.out.println(openAiParameters.serviceTier());
            System.out.println(openAiParameters.reasoningEffort());
        }

        System.out.println(requestContext.modelProvider());

        Map<Object, Object> attributes = requestContext.attributes();
        attributes.put("my-attribute", "my-value");
    }

    @Override
    public void onResponse(ChatModelResponseContext responseContext) {
        ChatResponse chatResponse = responseContext.chatResponse();

        AiMessage aiMessage = chatResponse.aiMessage();
        System.out.println(aiMessage);

        ChatResponseMetadata metadata = chatResponse.metadata();
        System.out.println(metadata.id());
        System.out.println(metadata.modelName());
        System.out.println(metadata.finishReason());

        if (metadata instanceof OpenAiChatResponseMetadata openAiMetadata) {
            System.out.println(openAiMetadata.created());
            System.out.println(openAiMetadata.serviceTier());
            System.out.println(openAiMetadata.systemFingerprint());
        }

        TokenUsage tokenUsage = metadata.tokenUsage();
        System.out.println(tokenUsage.inputTokenCount());
        System.out.println(tokenUsage.outputTokenCount());
        System.out.println(tokenUsage.totalTokenCount());
        if (tokenUsage instanceof OpenAiTokenUsage openAiTokenUsage) {
            System.out.println(openAiTokenUsage.inputTokensDetails().cachedTokens());
            System.out.println(openAiTokenUsage.outputTokensDetails().reasoningTokens());
        }

        ChatRequest chatRequest = responseContext.chatRequest();
        System.out.println(chatRequest);

        System.out.println(responseContext.modelProvider());

        Map<Object, Object> attributes = responseContext.attributes();
        System.out.println(attributes.get("my-attribute"));
    }

    @Override
    public void onError(ChatModelErrorContext errorContext) {
        Throwable error = errorContext.error();
        error.printStackTrace();

        ChatRequest chatRequest = errorContext.chatRequest();
        System.out.println(chatRequest);

        System.out.println(errorContext.modelProvider());

        Map<Object, Object> attributes = errorContext.attributes();
        System.out.println(attributes.get("my-attribute"));
    }
};

ChatModel model = OpenAiChatModel.builder()
        .apiKey(System.getenv("OPENAI_API_KEY"))
        .modelName(GPT_4_O_MINI)
        .listeners(List.of(listener))
        .build();

model.chat("Tell me a joke about Java");
attributes map 允许在同一 ChatModelListener 的 onRequest、onResponse 和 onError 方法之间传递信息,
以及在多个 ChatModelListener 之间传递信息。
如果你需要向监听器提供每次调用的元数据,请使用 ChatRequestOptions。
例如,你可以通过 listenerAttributes 向 ChatModelListeners
传递租户或关联标识符。这些选项仅在 LangChain4j 调用链内部使用;
它们不会发送给 LLM 提供商。
ChatRequest chatRequest = ChatRequest.builder()
        .messages(UserMessage.from("Tell me a joke about Java"))
        .build();

ChatRequestOptions options = ChatRequestOptions.builder()
        .addListenerAttribute("tenantId", "tenant-123")
        .addListenerAttribute("correlationId", "corr-456")
        .build();

model.chat(chatRequest, options);
同样适用于 StreamingChatModel.chat(chatRequest, options, handler)。
监听器如何工作
- 监听器以
List<ChatModelListener>形式指定,并按迭代顺序调用。 - 监听器在同一线程中同步调用。流式场景的更多细节见下文。 第二个监听器在第一个返回之前不会被调用。
ChatModelListener.onRequest()方法在调用 LLM 提供商 API 之前立即被调用。ChatModelListener.onRequest()方法每个请求只调用一次。 如果调用 LLM 提供商 API 时发生错误并发生重试,ChatModelListener.onRequest()不会为每次重试都被调用。ChatModelListener.onResponse()方法只调用一次, 紧接在从 LLM 提供商收到成功响应之后。ChatModelListener.onError()方法只调用一次。 如果调用 LLM 提供商 API 时发生错误并发生重试,ChatModelListener.onError()不会为每次重试都被调用。- 如果从某个
ChatModelListener方法抛出异常, 它将以WARN级别记录。后续监听器的执行将照常继续。 - 通过
ChatModelRequestContext、ChatModelResponseContext和ChatModelErrorContext提供的ChatRequest是最终请求,包含配置在ChatModel上的默认ChatRequestParameters与请求特定的ChatRequestParameters合并后的结果。 - 对于
StreamingChatModel,ChatModelListener.onResponse()和ChatModelListener.onError()在与ChatModelListener.onRequest()不同的线程上调用。 线程上下文目前不会自动传播,因此你可能希望使用attributesmap 将必要数据从ChatModelListener.onRequest()传播到ChatModelListener.onResponse()或ChatModelListener.onError()。 - 对于
StreamingChatModel,ChatModelListener.onResponse()在StreamingChatResponseHandler.onCompleteResponse()被调用之前调用。ChatModelListener.onError()在StreamingChatResponseHandler.onError()被调用之前调用。
审核模型可观测性
支持监听器的 ModerationModel 实现(例如 OpenAiModerationModel、MistralAiModerationModel
和 WatsonxModerationModel)允许配置 ModerationModelListener(s) 以监听如下事件:
- 对审核 API 的请求
- 来自审核 API 的响应
- 错误
以下是使用 ModerationModelListener 的示例:
ModerationModelListener listener = new ModerationModelListener() {

    @Override
    public void onRequest(ModerationModelRequestContext requestContext) {
        ModerationRequest moderationRequest = requestContext.moderationRequest();

        // Access texts being moderated
        System.out.println("Moderating texts: " + moderationRequest.texts());

        System.out.println(requestContext.modelProvider());
        System.out.println(moderationRequest.modelName());

        Map<Object, Object> attributes = requestContext.attributes();
        attributes.put("startTime", System.currentTimeMillis());
    }

    @Override
    public void onResponse(ModerationModelResponseContext responseContext) {
        ModerationResponse moderationResponse = responseContext.moderationResponse();

        Moderation moderation = moderationResponse.moderation();
        System.out.println("Flagged: " + moderation.flagged());
        if (moderation.flagged()) {
            System.out.println("Flagged text: " + moderation.flaggedText());
        }

        ModerationRequest moderationRequest = responseContext.moderationRequest();
        System.out.println(moderationRequest);

        System.out.println(responseContext.modelProvider());
        System.out.println(moderationRequest.modelName());

        Map<Object, Object> attributes = responseContext.attributes();
        Long startTime = (Long) attributes.get("startTime");
        if (startTime != null) {
            System.out.println("Duration: " + (System.currentTimeMillis() - startTime) + "ms");
        }
    }

    @Override
    public void onError(ModerationModelErrorContext errorContext) {
        Throwable error = errorContext.error();
        error.printStackTrace();

        ModerationRequest moderationRequest = errorContext.moderationRequest();
        System.out.println(moderationRequest);

        System.out.println(errorContext.modelProvider());
        System.out.println(moderationRequest.modelName());

        Map<Object, Object> attributes = errorContext.attributes();
        System.out.println(attributes.get("startTime"));
    }
};

ModerationModel model = OpenAiModerationModel.builder()
        .apiKey(System.getenv("OPENAI_API_KEY"))
        .listeners(List.of(listener))
        .build();

model.moderate("Text to check for policy violations");
attributes map 允许在同一 ModerationModelListener 的 onRequest、onResponse 和 onError 方法之间传递信息,
以及在多个 ModerationModelListener 之间传递信息。
监听器如何工作
- 监听器以
List<ModerationModelListener>形式指定,并按迭代顺序调用。 - 监听器在同一线程中同步调用。
ModerationModelListener.onRequest()方法在调用审核 API 之前立即被调用。ModerationModelListener.onRequest()方法每个请求只调用一次。 如果调用审核 API 时发生错误并发生重试,ModerationModelListener.onRequest()不会为每次重试都被调用。ModerationModelListener.onResponse()方法只调用一次, 紧接在收到成功响应之后。ModerationModelListener.onError()方法只调用一次。 如果调用审核 API 时发生错误并发生重试,ModerationModelListener.onError()不会为每次重试都被调用。- 如果从某个
ModerationModelListener方法抛出异常, 它将以WARN级别记录。后续监听器的执行将照常继续。
RAG 可观测性(EmbeddingModel、EmbeddingStore 和 ContentRetriever)
可以用监听器对 EmbeddingModel、EmbeddingStore 和 ContentRetriever 进行插桩,以观察:
- 延迟(使用
attributes测量时长) - 负载(例如
EmbeddingSearchRequest.queryEmbedding()以及检索到的匹配项/内容) - 错误
EmbeddingModel 监听器
实现 EmbeddingModelListener:
import dev.langchain4j.model.embedding.listener.EmbeddingModelListener;
import dev.langchain4j.model.embedding.listener.EmbeddingModelRequestContext;
import dev.langchain4j.model.embedding.listener.EmbeddingModelResponseContext;
import dev.langchain4j.model.embedding.listener.EmbeddingModelErrorContext;

public class MyEmbeddingModelListener implements EmbeddingModelListener {

    @Override
    public void onRequest(EmbeddingModelRequestContext requestContext) {
        requestContext.attributes().put("startNanos", System.nanoTime());
        // requestContext.embeddingRequest() exposes the inputs, per-call parameters (input_type, dimensions, ...)
        // and multimodal content. requestContext.modelProvider() identifies the provider.
    }

    @Override
    public void onResponse(EmbeddingModelResponseContext responseContext) {
        long startNanos = (long) responseContext.attributes().get("startNanos");
        long durationNanos = System.nanoTime() - startNanos;
        // Do something with duration and/or responseContext.embeddingResponse() (embeddings + metadata)
    }

    @Override
    public void onError(EmbeddingModelErrorContext errorContext) {
        // Do something with errorContext.error()
    }
}
通过模型构建器的 listeners(...) 方法附加监听器(推荐):
EmbeddingModel model = OpenAiEmbeddingModel.builder()
        .apiKey(System.getenv("OPENAI_API_KEY"))
        .modelName("text-embedding-3-small")
        .listeners(List.of(new MyEmbeddingModelListener()))
        .build();

model.embed("hello");
监听器会在 embed(EmbeddingRequest) 以及 embed(String) / embed(TextSegment)
便捷方法周围收到通知。
你也可以通过用 EmbeddingModel#addListener(s) 包装已构建的模型来附加监听器:
EmbeddingModel observedModel = embeddingModel.addListener(new MyEmbeddingModelListener());

observedModel.embed("hello");
这对于向已构建的模型,或向构建器未暴露 listeners(...) 的模型添加监听器很方便。
当构建器确实暴露 listeners(...) 时,请优先使用该方式,因为它不需要包装。
EmbeddingStore 监听器
实现 EmbeddingStoreListener:
import dev.langchain4j.store.embedding.listener.EmbeddingStoreListener;
import dev.langchain4j.store.embedding.listener.EmbeddingStoreRequestContext;
import dev.langchain4j.store.embedding.listener.EmbeddingStoreResponseContext;
import dev.langchain4j.store.embedding.listener.EmbeddingStoreErrorContext;

public class MyEmbeddingStoreListener implements EmbeddingStoreListener {

    @Override
    public void onRequest(EmbeddingStoreRequestContext<?> requestContext) {
        requestContext.attributes().put("startNanos", System.nanoTime());
    }

    @Override
    public void onResponse(EmbeddingStoreResponseContext<?> responseContext) {
        long startNanos = (long) responseContext.attributes().get("startNanos");
        long durationNanos = System.nanoTime() - startNanos;
        // Do something with duration and/or the response payload (if any), e.g.:
        if (responseContext instanceof EmbeddingStoreResponseContext.Search<?> search) {
            // Do something with search.searchResult()
        }
    }

    @Override
    public void onError(EmbeddingStoreErrorContext<?> errorContext) {
        // Do something with errorContext.error()
    }
}
使用 EmbeddingStore#addListener(s) 附加监听器:
EmbeddingStore<TextSegment> observedStore = embeddingStore.addListener(new MyEmbeddingStoreListener());

// Use observedStore as usual, e.g. in EmbeddingStoreIngestor / EmbeddingStoreContentRetriever
ContentRetriever 监听器
实现 ContentRetrieverListener:
import dev.langchain4j.rag.content.retriever.listener.ContentRetrieverListener;
import dev.langchain4j.rag.content.retriever.listener.ContentRetrieverRequestContext;
import dev.langchain4j.rag.content.retriever.listener.ContentRetrieverResponseContext;
import dev.langchain4j.rag.content.retriever.listener.ContentRetrieverErrorContext;

public class MyContentRetrieverListener implements ContentRetrieverListener {

    @Override
    public void onRequest(ContentRetrieverRequestContext requestContext) {
        requestContext.attributes().put("startNanos", System.nanoTime());
    }

    @Override
    public void onResponse(ContentRetrieverResponseContext responseContext) {
        long startNanos = (long) responseContext.attributes().get("startNanos");
        long durationNanos = System.nanoTime() - startNanos;
        // Do something with duration and/or responseContext.contents()
    }

    @Override
    public void onError(ContentRetrieverErrorContext errorContext) {
        // Do something with errorContext.error()
    }
}
使用 ContentRetriever#addListener(s) 附加监听器:
ContentRetriever observedRetriever = contentRetriever.addListener(new MyContentRetrieverListener());

observedRetriever.retrieve(Query.from("my query"));
监听器如何工作
- 监听器以
List形式指定,并按迭代顺序调用。 - 监听器在同一线程中同步调用。
onRequest()在执行底层操作之前立即被调用。onResponse()在成功完成后调用一次。- 如果底层操作抛出异常,
onError()调用一次。 - 如果从某个监听器方法抛出异常,它将以
WARN级别记录并被忽略。 attributesmap 允许在同一监听器的onRequest、onResponse和onError方法之间传递信息, 以及在多个监听器之间传递信息。
使用 Micrometer 的可观测性指标
langchain4j-micrometer-metrics 模块为 LangChain4j 库提供基于 Micrometer 的指标实现。
当前,它通过一个使用 Micrometer 的 MeterRegistry 收集指标的 ChatModelListener 实现,
为 ChatModel 和 StreamingChatModel 交互提供指标。
指标命名遵循 OpenTelemetry Semantic Conventions for Generative AI Metrics。(v1.39.0)
⚠️ 实验性:此模块标记为
@Experimental,未来版本可能出现破坏性变更。
⚠️ 警告:OpenTelemetry Generative AI 语义约定目前仍为实验性且不稳定。这意味着未来版本可能出现破坏性变更。如果你遵循这些约定,在约定更新时可能需要引入破坏性变更到你的仪表盘、告警和自动化中。
指标
当前收集的指标如下:
| 指标名称 | 类型 | 描述 |
|---|---|---|
gen_ai.client.token.usage | Histogram (DistributionSummary) | 每次 chat 模型请求使用的输入和输出 token 数量 |
gen_ai.client.token.usage 上的标签
| 标签 | 描述 | 示例值 |
|---|---|---|
gen_ai.operation.name | 正在执行的操作 | chat |
gen_ai.provider.name | AI 提供商名称 | openai、azure.ai.inference、anthropic |
gen_ai.request.model | 请求中的模型名称 | gpt-4、gpt-35-turbo |
gen_ai.response.model | 响应中的模型名称 | gpt-4-0613 |
gen_ai.token.type | 被计数的 token 类型 | input、output |
创建 MicrometerMetricsChatModelListener
MicrometerMetricsChatModelListener 为 ChatModel 和 StreamingChatModel 交互收集指标。
它需要一个 Micrometer 的 MeterRegistry 来实例化。
import dev.langchain4j.data.message.UserMessage;
import dev.langchain4j.micrometer.metrics.listeners.MicrometerMetricsChatModelListener;
import dev.langchain4j.model.azure.AzureOpenAiChatModel;
import dev.langchain4j.model.chat.request.ChatRequest;
import dev.langchain4j.model.chat.response.ChatResponse;
import io.micrometer.core.instrument.MeterRegistry;

import java.util.List;

// Get the MeterRegistry
MeterRegistry meterRegistry = new SimpleMeterRegistry();

// 1. Create the listener with the MeterRegistry and AI system name
MicrometerMetricsChatModelListener listener =
    new MicrometerMetricsChatModelListener(meterRegistry);

// 2. Add the listener to your ChatModel
AzureOpenAiChatModel chatModel = AzureOpenAiChatModel.builder()
        .endpoint(System.getenv("AZURE_OPENAI_ENDPOINT"))
        .apiKey(System.getenv("AZURE_OPENAI_KEY"))
        .deploymentName(System.getenv("AZURE_OPENAI_DEPLOYMENT_NAME"))
        .listeners(List.of(listener))
        .build();

// 3. Use the chat model as usual - metrics are collected automatically
ChatResponse response = chatModel.chat(ChatRequest.builder()
        .messages(UserMessage.from("Hello!"))
        .build());
Micrometer Observation API
该实现使用 Micrometer Observation API 实现 ChatModelListener,从而可透明地生成指标与追踪。
这在 langchain4j-observation 模块中实现。
产生的遥测数据
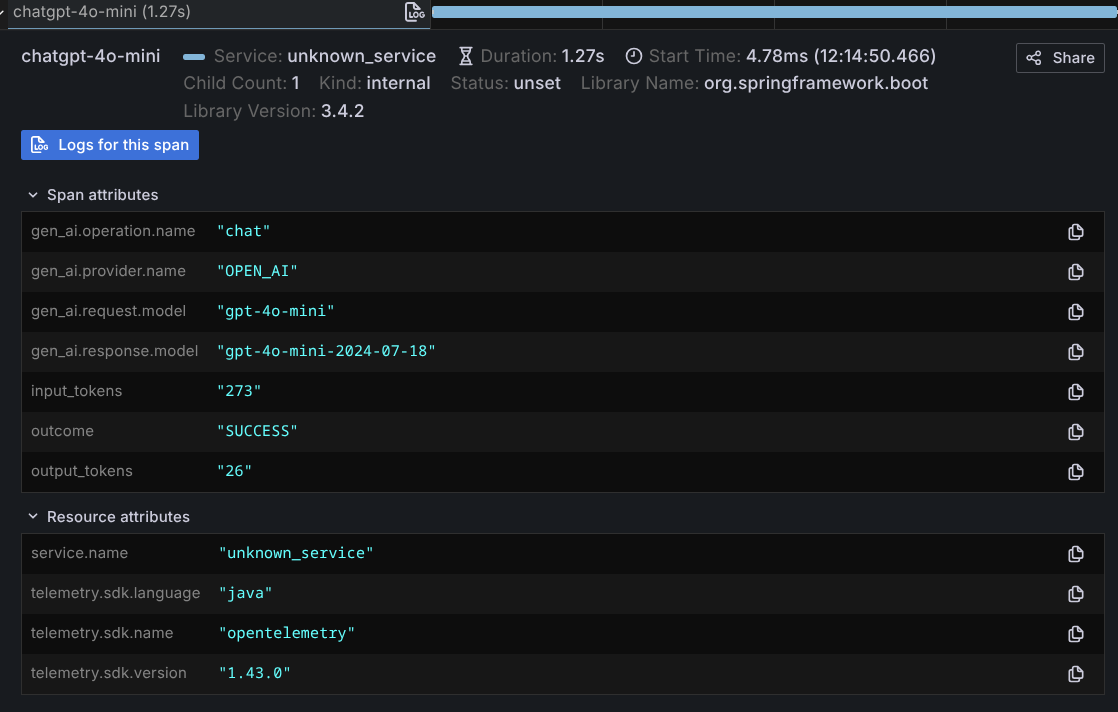
追踪
这将为每次 chat 交互提供 span。
示例:
指标
以下指标的直方图:
- gen_ai_client_token_usage
- gen_ai_client_operation_duration
示例:
# HELP gen_ai_client_operation_duration_active_seconds
# TYPE gen_ai_client_operation_duration_active_seconds summary
gen_ai_client_operation_duration_active_seconds_count{gen_ai_operation_name="chat",gen_ai_provider_name="OPEN_AI",gen_ai_request_model="gpt-4o-mini",gen_ai_response_model="unknown",outcome="SUCCESS"} 0
gen_ai_client_operation_duration_active_seconds_sum{gen_ai_operation_name="chat",gen_ai_provider_name="OPEN_AI",gen_ai_request_model="gpt-4o-mini",gen_ai_response_model="unknown",outcome="SUCCESS"} 0.0
# HELP gen_ai_client_operation_duration_active_seconds_max
# TYPE gen_ai_client_operation_duration_active_seconds_max gauge
gen_ai_client_operation_duration_active_seconds_max{gen_ai_operation_name="chat",gen_ai_provider_name="OPEN_AI",gen_ai_request_model="gpt-4o-mini",gen_ai_response_model="unknown",outcome="SUCCESS"} 0.0
# HELP gen_ai_client_operation_duration_seconds
# TYPE gen_ai_client_operation_duration_seconds summary
gen_ai_client_operation_duration_seconds_count{error="none",gen_ai_operation_name="chat",gen_ai_provider_name="OPEN_AI",gen_ai_request_model="gpt-4o-mini",gen_ai_response_model="gpt-4o-mini-2024-07-18",outcome="SUCCESS"} 2
gen_ai_client_operation_duration_seconds_sum{error="none",gen_ai_operation_name="chat",gen_ai_provider_name="OPEN_AI",gen_ai_request_model="gpt-4o-mini",gen_ai_response_model="gpt-4o-mini-2024-07-18",outcome="SUCCESS"} 3.384050045
# HELP gen_ai_client_operation_duration_seconds_max
# TYPE gen_ai_client_operation_duration_seconds_max gauge
gen_ai_client_operation_duration_seconds_max{error="none",gen_ai_operation_name="chat",gen_ai_provider_name="OPEN_AI",gen_ai_request_model="gpt-4o-mini",gen_ai_response_model="gpt-4o-mini-2024-07-18",outcome="SUCCESS"} 2.115592691
# HELP gen_ai_client_token_usage_tokens Measures the quantity of used tokens
# TYPE gen_ai_client_token_usage_tokens summary
gen_ai_client_token_usage_tokens_count{gen_ai_operation_name="chat",gen_ai_provider_name="OPEN_AI",gen_ai_request_model="gpt-4o-mini",gen_ai_response_model="gpt-4o-mini-2024-07-18",gen_ai_token_type="input"} 2
gen_ai_client_token_usage_tokens_sum{gen_ai_operation_name="chat",gen_ai_provider_name="OPEN_AI",gen_ai_request_model="gpt-4o-mini",gen_ai_response_model="gpt-4o-mini-2024-07-18",gen_ai_token_type="input"} 508.0
gen_ai_client_token_usage_tokens_count{gen_ai_operation_name="chat",gen_ai_provider_name="OPEN_AI",gen_ai_request_model="gpt-4o-mini",gen_ai_response_model="gpt-4o-mini-2024-07-18",gen_ai_token_type="output"} 2
gen_ai_client_token_usage_tokens_sum{gen_ai_operation_name="chat",gen_ai_provider_name="OPEN_AI",gen_ai_request_model="gpt-4o-mini",gen_ai_response_model="gpt-4o-mini-2024-07-18",gen_ai_token_type="output"} 53.0
# HELP gen_ai_client_token_usage_tokens_max Measures the quantity of used tokens
# TYPE gen_ai_client_token_usage_tokens_max gauge
gen_ai_client_token_usage_tokens_max{gen_ai_operation_name="chat",gen_ai_provider_name="OPEN_AI",gen_ai_request_model="gpt-4o-mini",gen_ai_response_model="gpt-4o-mini-2024-07-18",gen_ai_token_type="input"} 273.0
gen_ai_client_token_usage_tokens_max{gen_ai_operation_name="chat",gen_ai_provider_name="OPEN_AI",gen_ai_request_model="gpt-4o-mini",gen_ai_response_model="gpt-4o-mini-2024-07-18",gen_ai_token_type="output"} 27.0
Spring Boot 应用中的可观测性
更多细节见 此处。
关于如何在 Spring Boot 应用中收集 Micrometer 指标的更多细节见 此处。
关于如何将 Micrometer Observation API 库与 SpringBoot 集成的细节见 此处。
第三方集成
OpenTelemetry GenAI 插桩
社区维护的 otel-genai-bridges 项目提供了一个 Spring Boot starter,使用 OpenTelemetry Generative AI semantic conventions 自动为 LangChain4j chat 应用插桩。
为什么使用它?
- 包装任何
ChatModelbean,并发出 span、事件和指标。 - 开箱即用地捕获提示、补全、工具调用、延迟、token 用量、成本以及 RAG 检索延迟。
- 提供 Docker Compose 示例(Collector → Tempo/Prometheus → Grafana)以及预构建的 Grafana 仪表盘。
入门
将 starter 添加到你的 Spring Boot 项目:
<!-- pom.xml -->
<dependency>
  <groupId>com.dineshkumarkummara.otel</groupId>
  <artifactId>langchain4j-otel</artifactId>
  <version>0.1.0-SNAPSHOT</version>
</dependency>
通过 application.yaml 启用 starter:
otel:
  langchain4j:
    enabled: true
    system: openai
    default-model: gpt-4o
    capture-prompts: true
    capture-completions: true
    cost:
      enabled: true
      input-per-thousand: 0.0005
      output-per-thousand: 0.0015
嵌套的 cost 段落是可选的;当你想要按 token 的成本指标时再包含它。
依赖在类路径上后,starter 会自动定位 ChatModel bean 并用遥测包装它们。
可观测性视图

完整可运行示例(包括可观测性栈和 Semantic Kernel 对等实现)见 dineshkumarkummara/otel-genai-bridges。